あどけない話

Internet technologies

My Stance on OSS Development and AI Programming (as of October 2026)

OSS開発とAIプログラミングに対する私の立場(2026年10月現在)

By 2026, AI has fundamentally transformed software development. I’ll freely admit that, until quite recently, I was skeptical about using AI for programming. However, ever since I started using Claude on September 15th, my perspective has shifted 180 degrees.

2026年は、AI がソフトウェア開発を大きく変えてしまいました。つい最近まで、私はAIを使ったプログラミングに懐疑的だったことを素直に認めます。しかし、9月15日にClaudeを使い始めて以降、私の考えは180度変わりました。

I thought it might be meaningful to document my current thoughts on AI-assisted programming, a record of my mindset during this pivotal turning point in history.

この時代の転換期に自分がどのようなことを考えていたのか、記録を残すことは、もしかすると意味があるのではないかと思い、現在のAIプログラミングに対する考えを書いておきます。

I develop and maintain a large number of open-source software (OSS) projects, and I’ve been receiving a high volume of bug reports generated by AI. The sheer quantity eventually exceeded my capacity to handle them, which is what led me to start using AI myself. My goal is to identify and fix bugs, especially vulnerabilities, proactively, before others discover them.

私はたくさんのOSSを開発・保守しており、AIが作成したバグレポートをたくさん受け取っていました。あまりの量に、私の処理能力を超えたと感じ、AIを使い始めました。他の人が私の関わっているソフトウェアのバグを見付ける前に、先回りして直しておこうと思ったのです。特に脆弱性です。

I’ll never forget the shock I felt the first time I asked Claude to analyze my software and point out any issues. I was genuinely alarmed by how easily it could uncover so many vulnerabilities.

Claudeに「このソフトウェアを分析して問題を指摘してください」と初めてお願いし、結果を見たときの衝撃は忘れられません。こんなにも簡単に、こんなにも多くの脆弱性を見付けられるのかと焦りました。

"Keep running faster than bad guys": that is the guiding principle for how I operate in these turbulent times.

悪者よりも速く走る:これが、この嵐のような時代の私の行動原理です。

I welcome bug reports that are clearly AI-generated. It doesn’t matter if they are verbose; I don’t expect the person submitting the report to have deep, specialized knowledge of the software.

私は、明らかにAIが書いたようなバグレポートを歓迎します。それが冗長であっても構いません。報告者に私が関わるソフトウェアに対する深い知識は求めません。

In software development, it’s standard practice to write issues and pull/merge requests in English. However, since I can process information 100 times faster in Japanese, I frequently rely on automated translation. Asking an AI to "summarize the key points" of a long-winded report is, in practice, not much different from using an automated translation tool.

ソフトウェアの開発では、issue や pull/merge request を英語で書く慣習がありますが、私は日本語の方が100倍速く理解できますので、頻繁に自動翻訳を利用します。冗長なレポートに対して、AIに「要点をまとめて」と指示するのは、自動翻訳を使うのと大差はないのです。

In fact, I worry that imposing overly strict requirements might discourage people from submitting reports at all. If you are Japanese, please feel free to submit your reports in Japanese. Those who speak other languages can simply use automated translation if they need to understand the content.

むしろ、過度な要求をすることで、報告が減ることを恐れます。もし、あなたが日本人であれば、日本語で報告してください。他の言語を母国語とする人たちは、必要であれば、自動翻訳を通して読めばいいのです。

Conversely, if a software community I contribute to decides to ban text generated by AI, I will abide by that. However, my time is extremely limited; the more demanding a request is, the lower its priority will be. There is no time to play music leisurely while the ship is sinking.

逆に、私が貢献するソフトウェアのコミュニティが、AIで書いた文章を禁止すると言えば、それに従います。しかし、時間は本当に限られていますので、要求が高ければ高いほど、後回しになります。船が沈もうとしているのに、悠長に音楽を奏でている暇はないのです。

Sometimes, I use AI to respond to reports regarding my software on my behalf. I am aware that some people may find AI-generated responses unpleasant. However, there are instances where an AI can provide a more accurate answer than I could myself. Furthermore, there are times when I am simply too busy, and I judge it better to have an AI provide a response rather than keeping the other person waiting.

私のソフトウェアへの報告に対して、私の代わりにAIに答えてもらうことがあります。AIによる回答に不快な気分になる人がいることは承知しています。しかし、私が答えるよりもAIが答えた方が正確な場合があります。また、あまりに忙しく、相手を待たせるよりも、AIに答えてもらう方がよいと判断することもあります。

Please do not take offense; I mean no harm. I am fond of the Chinese proverb, "Those engaged in a great undertaking do not concern themselves with minor formalities." When the task at hand is as significant as fixing a vulnerability, please overlook any minor lapses in etiquette.

悪気はありませんので、どうか不快に思わないでください。私は、「大行は細謹を顧みず」という中国の言葉が好きです。脆弱性を直すという大きな行いを前にして、小さな無礼は気にしないでください。

In an era where AI can easily uncover vulnerabilities, I see no point in trying to hide them. Whether it concerns a vulnerability or otherwise, I submit pull/merge requests as usual, merge them once the CI checks pass, and release updates as quickly as possible. If you use the software I develop, please update to the latest version as frequently as you can. I, for one, reboot my own Linux system almost every day.

AIが簡単に脆弱性を発見する時代に、脆弱性を隠すことに意味は感じません。私は、脆弱性であろうと通常通り pull/merge requestを出し、CIが緑になったらマージし、できるかぎり早くリリースします。私が開発しているソフトウェアをお使いの方は、できるだけ頻繁にバージョンアップしてください。私も毎日のように Linux をリブートしています。

I hope that once we navigate through these turbulent times, we will reach a future where we can develop the software we love alongside AI, a highly capable colleague.

この激動の時代を乗り切れば、AIという優秀な同僚と好きなソフトウェアを開発できる日々が訪れることを祈っています。
Releasing crypton v2.0.0

crypton is a cryptographic library widely used in the Haskell community. However, the library had several issues:

  • It did not utilize hardware acceleration at all on ARM.
  • Although it utilized hardware acceleration on x86, it was slower than standard OpenSSL.
  • There were concerns regarding its security.

To address these issues, I had been vaguely considering the following approaches:

  • Building an API similar to crypton on top of botan-binding
  • Discarding crypton's cbits and replacing them with something like OpenSSL

While I consider myself more knowledgeable about cryptography than the average person (in Japan, I am known as the supervising translator of the O'Reilly book on PGP), I am not a cryptography expert, so I cannot write code that is both correct and performant. Having recently started using Claude Code, I wondered if the AI could write the code for me, so I consulted it on the approach to take.

Claude Code's answer was unexpected:

  • Binary distributions for Botan might not be available, and building from source—given that it is written in C++—imposes a heavy burden in terms of setting up a C++ compiler.
  • The history of the Haskell community demonstrates just how difficult it is to maintain OpenSSL bindings.

The argument was that crypton's strength lies in being self-contained and portable—qualities that shouldn't be sacrificed—and that the best approach is actually to improve the cryptographic implementations found in cbits. While there may be various opinions on the matter, I decided to trust this approach.

First, I fixed all the vulnerabilities identified by Claude Code. The main ones were that ECDH and the elliptic curve primitives accepted public points outside the prime-order subgroup, which is what a small-subgroup attack needs, and that the secret key types printed their secrets through their derived Show instances—so a key could reach a log file by way of an ordinary debugging line. The former is now checked; the latter is redacted, and Crypto.Debug is the explicit way to print a key when you really mean to. Version 1.1.5 incorporates many of the fixes contributed by Ville Vesilehto, effectively building upon that work.

Next, I implemented all the performance optimization techniques suggested by Claude Code. In cases where no further speed improvements could be achieved through C-level optimizations, I integrated assembly code that was free of licensing issues.

A performance comparison table is available in the README of the crypton GitHub repository. For several cryptographic algorithms, it rivals OpenSSL, and in some cases, even outperforms it.

The current challenge lies with P-256; it runs at roughly a third of OpenSSL's speed on x86-64, and a little under half on AArch64. To accelerate P-256, an assembly implementation with a compatible license is required. If you have any ideas, please post them in the issue tracker.

We released v2.0.0 after relaxing version constraints to ensure it could be readily used by other libraries. A crash was reported almost immediately: on a Skylake machine, SHA-512 died with SIGILL on a vprotq instruction—an AMD XOP opcode, on an Intel processor that has never had XOP.

The vendored assembly was not at fault. It reads bit 11 of a capability word as "this processor has XOP", which is the convention OpenSSL's own assembly uses. What crypton got wrong was filling that word. XOP lives in CPUID leaf 0x80000001, but crypton stored raw leaf 1 ECX, whose bit 11 is SDBG—a silicon debug flag that Intel has reported since Broadwell. OpenSSL clears that bit before merging the real XOP flag into its place; crypton did neither half. ChaCha20 would have failed the same way on the same processors; the reporter simply reached SHA-512 first. We cleared the bit and released v2.0.1.

The lesson I take from it is that importing code means importing its assumptions too, and not merely its instructions.

Update: In crypton v2.1.2, thanks to AWS's s2n-bignum library, P-256 performance now rivals that of OpenSSL.

哀しみの果てのNSEC3

NSEC3に関する備忘録。NSECを知っているから、NSEC3も分かっている気になっている者だけが、続きを読みなさい。

NSECの問題点とNSEC3

NSECの問題点としては、2つ挙げられる。

  1. DNSSECに対応してない子のゾーンに対してもNSEC RRを作る。そのため、登録・解除が多いゾーンだと、権威サーバの負荷が大きい。
  2. Next Domain Nameフィールドをたどっていけば、そのゾーンの名前を列挙できてしまう。

これらの問題を解決するために、NSEC3が考え出された。問題1)に関しては、Opt-Outの機能を提供するが、このブログでは詳しくは触れない。

問題2)を解決するために、NSEC3では名前はSHA1などを使ってハッシュ化される。名前はハッシュ化されたあと、順序づけられ、所有名にも、次の名前(Next Hashed Owner Name)にも、このハッシュ化された名前が使われる。

% dig @dns0.iij.ad.jp aaa.iij.ad.jp +dnssec
RTRHHSUCLS2ANMR2E0V7E73QMKOGD5GJ.iij.ad.jp. 3600 IN NSEC3 1 1 6 1EDA77D76A990D63 S1LBO3J0GNPJ2CSTGT21FPP7JTC07DHM  A AAAA RRSIG

NSEC3で導入された概念

NSEC3を理解するためには、どうしても2つの新しい概念を理解する必要がある。理解できれば当たり前なのだが、理解できない内は我慢して定義を頭に入れて欲しい。

最近接名(Closest Encloser)
問い合わせ名の先祖の中で、存在する最も長い名前
次近接名(Next Closer Name)
問い合わせ名の先祖の中で、存在しない最も短い名前

これは、JPRSの訳語に従っている。次近接名の方は適切だと思うが、最近接名の方には個人的には納得できない。Encloserとは、「囲む人」みたいな意味で、僕なら「最近包含」ぐらいに訳していただろう。

以下の性質を理解することは重要である:

  1. 次近接名から1つラベルを取り除くと、最近接名である
  2. 次近接名の末端のラベルを "*" に置き換えるとワイルドカードになる

性質1)の説明はむしろ逆で、問い合わせ名からラベルを一個ずつ取り除いていって、最初に存在したものが最近接名であり、最後に取り除いたラベルを最近接名に付け直すと次近接名になる。

例として以下のドメインを考える。

example.jp.
foo.example.jp.

問い合わせ名が "woo.baz.bar.foo.example.jp." である場合:

  • 最近接名は、"foo.example.jp."
  • 次近接名は、"bar.foo.example.jp."
  • ワイルドカードは、"*.foo.example.jp."

さらに以下の2つの性質を理解して欲しい:

  • 最近接名は存在するのだから、最近接名に対しては「一致」するNSEC3 RR を使う
  • 次近接名は存在しないのだから、次近接名に対しては「カバー」するNSEC3 RR を使う

この記事でいうワイルドカードとは、「もしあるとしたら、そういう名前になる」という意味も含む。実際、ワイルドカードの存在を証明する場合もあるし、「不在」を証明することもあるのだから。

NSEC3の利用方法とNSECとの対比

NSECと同様にNSEC3の利用方法も5つある。以下の省略記号を用いて、利用される証拠を対比してみよう。

  • Q: 問い合わせ名 (Question name)
  • W: ワイルドカード (Wildcard)
  • C: 最近接名 (Closest encloser) -- 常に一致
  • N: 次近接名 (Next closer name) -- 常にカバー
NSEC NSEC3
No Data Qに一致 Cに一致
未署名ゾーンへの委任 Qをカバー Cに一致、Nをカバー
Name Error(NXDOMAIN) Qをカバー、Wをカバー Cに一致、Nをカバー、Wをカバー
ワイルドカード応答 Qをカバー N をカバー
ワイルドカード No Data Qをカバー、Wに一致 Cに一致、Nをカバー、Wに一致

だいたい、NSECの「問い合わせ名をカバー」が、NSEC3では「最近接名に一致」と「次近接名をカバー」に置き換えられていることが見て取れるだろう。

「次近接名をカバー」は、問い合わせ名の存在を否定するために使われている。次近接名が問い合わせ名自身なら、カバーされて存在しない。次近接名が先祖なら、その名前は存在せず、それゆえに子孫である問い合わせ名も存在しない。

では、「最近接名に一致」はなぜ必要なのだろうか? リゾルバの立場になって考えてみよう。リゾルバができることは、手に入れたNSEC3 RRのリストに対して、検査したい名前のハッシュを取り、一致する、あるいはカバーするエントリを探すことだけである。これをラベルを削りながら繰り返す。

「カバー」だと範囲が広いが、「一致」なら確実に、その名前に対するNSEC3だと分かり、その名前は存在すると判断できる。そして、一つラベルを増やした名前は、絶対に存在しない。だから、名前の不在を証明するためには、ラベルを一つ増やして、カバーするNSEC3のエントリを探せばよい。

この方法は、ワイルドカードを「カバー」するNSEC3 RRを探す際にも利用できる。

NSECには最近接名がなくていいのか

翻って、もう一度表のNSECのカラムを見てみよう。Name Errorの行に、「ワイルドカードをカバー」とある。NSEC3で、最近接名からワイルドカードを決定できると知った今、最近接名という概念のないNSECで正しくワイルドカードを算出できるのだろうか?

以下のゾーンを利用し、問い合わせ名 "baz.bar.foo.example.jp." のワイルドカードについて考える。

example.jp.
boo.example.jp.
woo.hoo.example.jp.

すべての情報を知っている権威サーバなら、ワイルドカードは "*.example.jp." だと分かる。

リゾルバが、最近接名を知らされない場合、ワイルドカードとしては以下の可能性が考えられるだろう。

  • *.bar.foo.example.jp.
  • *.foo.example.jp.
  • *.example.jp.

NSECでは、以下のNSEC RRが送られている

  1. example.jp. 〜 boo.example.jp. (ワイルドカード *.example.jp. をカバー)
  2. boo.example.jp. 〜 woo.hoo.example.jp. (問い合わせ名 baz.bar.foo.example.jp. をカバー)

よく見ると、2)は本当のワイルドカード以外のワイルドカードをカバーしていることが分かるだろう。そして、1)が本当のワイルドカードをカバーするから、証拠としてはこの2つで十分だ。

それぞれのラベルを削って "*" に置き換えて行きながら検証すると、すべてがどちらかの NSEC RR にカバーされると分かる。

このナイーブな方法でもよいが、実は最近接名を算出する方法がある。問い合わせ名をカバーするNSEC RRに対して:

  • 問い合わせ名と所有名の共通部分を取り出す
  • 問い合わせ名と次の名前の共通部分を取り出す
  • 両者の内、長い方が最近接名である

やってみよう。

  • baz.bar.foo.example.jp. と boo.example.jp. の共通部分は example.jp.
  • baz.bar.foo.example.jp. と woo.hoo.example.jp. の共通部分は example.jp.
  • 最近接名は、example.jp.
  • よって、ワイルドカードは *.example.jp.

問い合わせ名が qoo.hoo.example.jp. の場合:

  • qoo.hoo.example.jp. と boo.example.jp. の共通部分は example.jp.
  • qoo.hoo.example.jp. と woo.hoo.example.jp. の共通部分は hoo.example.jp.
  • 最近接名は、hoo.example.jp.
  • よって、ワイルドカードは *.hoo.example.jp.

嗚呼 Empty Non-Terminal

NSEC方式では、ENT(Empty Non-Terminal)に対するNSEC RRは作られなかった。NSEC3方式では、ENTの存在に気づく方法がないので、ENTに対してNSEC3 RRが作られる。

ENTが存在していても、NSEC方式で最近接名が算出できることは、上記の例で示されている。hoo が ENT であった。

哀しみの果てのNSEC

NSECに関する備忘録。DNSの否定応答とDNSSECの肯定応答を理解している者だけが、続きを読みなさい。

SOA RR + RRSIG

RRSIG RRは、返すRRSet (同じ名前とタイプを持つRRの集合)に対して作成された署名を格納する。否定応答では、答えとして返すRRSetがないから、何に署名すればいいのだろう?

DNSの否定応答には、権威セクションにSOA RRが入る。これは、ネガティブキャッシュのTTLをフルリゾルバに伝えるためである。DNSSECの否定応答では、SOAにRRSIGが付いてくるので、一見これだけでもよさそうな気がする。

それが誤りだと理解するために、SOAとそのRRSIGを否定応答の証拠として使う方法を考えよう。悪者が一旦、SOAとそのRRSIGを手に入れたなら、権威サーバからの肯定応答を横取りし、さまざまな否定応答にすり替える攻撃が成立する。

DNSSECの設計思想として、RRSIGはゾーンデータを読み込む際に作成され、問い合わせを受けた際に署名を作成する方法は、一般的には受け入れられない。そのため、安全なDNSSEC否定応答のためには、前もって署名できる何らかのRRSetが必要である。

このRRSetとして、ドメインの範囲を示すRRが考えられた。それがNSEC(Next Secure)である。

NSECの例と意味

NSECが利用されている有名な実例は、ルートゾーンである。存在しない名前 "c." を検索してみよう。

% dig @a.root-servers.net. c. txt +dnssec +norecurse
bzh.   86400 IN   NSEC   ca.   NS DS RRSIG NSEC

bzh. という名前に対して、NSEC RR が返って来ている。次のドメインは "ca."である。これは、"bzh." と "ca." は存在するが、その間にはドメインが存在しないことを意味する。すなわち、"c." は存在しない。

NSECは、ドメインの不在を示す証拠だと思っている人も多いだろうが、それは役割の半分に過ぎない。以下で用語を定義して、2つの役割を説明する。

あるドメインに一致するNSEC RR
そのドメインが「存在する」ことを示し、またどのタイプが存在するかも示す。(RFC 4035: "exactly match", RFC 5155: "match")
あるドメインをカバーするNSEC RR
そのドメインが「存在しない」ことを示す。(RFC 4035: "match", RFC 5155: "cover")

たとえば、上記の例は、 "bzh." ドメインが存在し、かつ NS DS RRSIG NSEC というタイプのRRを提供していることを証明している。

5つの役割

NSECが利用されるのは、以下の5つの場合である。

  • No Data
  • 未署名ゾーンへの委任
  • Name Error(NXDOMAIN)
  • ワイルドカード応答
  • ワイルドカード No Data

これらを正確に理解するためには、ENT(Empty Non-Terminal:空の中間名)とワイルドカードに対する知識が必要である。

No Data

ドメインは存在するが、問い合わせたタイプは存在しないことを示すには、その名前に一致するNSEC RRとそのRRSIGを権威セクションに入れて返す。これは理解しやすいだろう。

ただし、ENTが絡んでくると話はややこしくなる。以下にENTの例を示す。

_8443._https.example.jp. 7200 IN HTTPS 1 . alpn=h3

これは、8443ポートでHTTP/3のサービスを提供していることを示すHTTPS RRである。末端の "_8443"は HTTPS RRを提供するが、中間の "_https" には一般的にRRが関連づけられてない。このように、ENTとは空の中間名のことである。

DNS で、ENT を検索した際は、Name ErrorではなくNo Dataを返さなければならない。上記の例では、"_https.example.jp."をどんなタイプで検索しても、No Dataが返る。

ちなみに、単に No Dataが返っても、その名前がENTなのか、単に問い合わせのタイプがないだけで、他のタイプがあるのか、区別は付かない。ENTだと確証を得るには、ANYという特殊なタイプで問い合わせるといいだろう。権威サーバの多くの実装では、ANYに対して、存在するRRのどれか一つを返す。

NSEC RRは、ENTに対しては作られないことになっている。つまり、DNSではENTは存在するが、NSECではENTは存在しないような扱いなのである。ENTに対してNo Dataを返す際に権威サーバができるのは、そのドメインを「カバーする」NSEC RR を付けることだ。

上記の例では、以下のようなNSEC RRになるだろう。

foo.example.jp.   86400 IN   NSEC   _8443._https.example.jp.   HTTPS

一致しているNSEC RRではないから、タイプの一覧は何の証明にもならない。そこで、フルリゾルバは、Next Domain Nameフィールドが示す名前を調べる。その名前が、対象名のサブドメインなら、対象名がENTだと分かる。この例では、Next Domain Nameである"_8443._https.example.jp."が、問い合わせ名"_https.example.jp."のサブドメインとなる。

ENTであれば、何のタイプも提供しない。だから、No Dataだと証明される。やれやれ。

権威サーバの実装では、ENTを特別扱いする必要はない。NSECの範囲において、「はじまり」は含むが、「おわり」は含まれないとして扱うと、一致とカバーを統合できる。

未署名ゾーンへの委任

子のゾーンへの委任は、当然NS RRが存在する。親のゾーンは、子のNS RRは所有していない。所有するのは、子自身である。よって、子のNS RRSetに対するRRSIGは作成されない。

子のゾーンには、署名されている場合(DNSSEC対応済み)とそうでない場合(DNSSEC未対応)がある。署名されているゾーンへの委任には、NS RRに加えて、DS RRが存在する。

子のゾーンのDS RRは、なんと親ゾーンが所有しているので、RRSIGが作られる。

子のゾーンが署名されていようと、なかろうと、そのゾーン名に一致するNSEC RRは作成される。

署名されたゾーンへの委任を返す場合、DS RR とその RRSIG が返されるので、DSが存在することを証明できる。

% dig @a.dns.jp. iij.ad.jp. txt +dnssec +norecurse
iij.ad.jp.  86400 IN NS dns0.iij.ad.jp.
iij.ad.jp.  86400 IN NS dns1.iij.ad.jp.
iij.ad.jp.   7200 IN DS 45574 8 2 ...
iij.ad.jp.   7200 IN RRSIG DS 8 3 ...

一方で、署名されていないゾーンへの委任を返す場合、DS RRが存在しないことを証明する必要がある。そのために、署名されていないゾーン名に一致するNSEC RRを返す。そのタイプリストには DS が含まれていない。

(NSEC3が主流のため、この例を探すのは難しいので割愛。)

Name Error

問い合わせ名が存在しないことを示すのだから、その名前をカバーするNSEC RRを返す。しかし、これだけでは不十分である。なぜなら、DNSにはワイルドカードという機能があるからだ。

ワイルドカードに対して深い理解が必要になるのはNSEC3なので、NSECを扱うこのブログでは、表面的に理解しておけばよい。ワイルドカードの例を以下に示す。

foo.example.jp.  A
*.example.jp.    TXT

権威サーバは、あるドメイン内でラベルを探す際に、発見できなければ、"*"というラベルを探すことを試みる。大切なので、もう一回述べるが、"*" という単なる文字列を探す。頭の中で、勝手に深い意味を与えてはいけない。

たとえば、この例で "bar.example.jp."に対して問い合わせが来たとしよう。"example.jp."で、"bar"を探すと存在しない。しかし、"*"は存在する。そこで、"*.example.jp"に付随しているRRを回答セクションにコピーし、"*.example.jp."を問い合わせ名の"bar.example.jp."で置き換える。

DNSの範囲では、回答が存在するドメイン名から得られたのか、ワイルドカードから生成されたのかは区別が付かない。

DNSSECで、Name Errorを返す場合は、ワイルドカードも存在しないことを示す必要がある。存在しないのだから、ワイルドカードを「カバーする」NSEC RRを返す。

このように、一般的には2つのNSEC RRを返すが、問い合わせ名と"*"がたまたま同じ範囲に入っている場合は、1つのNSEC RRを返す。

上記の例では、話を簡単にするために、NSECを1つだけ示したが、本当は2つ返ってくる。

% dig @a.root-servers.net. c. txt +dnssec +norecurse
bzh.   86400 IN   NSEC   ca.   NS DS RRSIG NSEC
.      86400 IN   NSEC   aaa.  NS SOA RRSIG NSEC DNSKEY TY

"bzh." 〜 "ca." の範囲が "c." をカバーし、"." 〜 "aaa." の範囲が "*" をカバーする。ということは、"a."を検索すると、"." 〜 "aaa." の範囲だけが返ってくるはずである。

% dig @a.root-servers.net. a. txt +dnssec +norecurse
.      86400 IN   NSEC   aaa.  NS SOA RRSIG NSEC DNSKEY TY

ワイルドカード応答

問い合わせ名は存在しないが、マッチするワイルドカードがあって、しかも問い合わせタイプを提供している場合、問い合わせ名をカバーするNSEC RRを返す。

ワイルドカードNo Data

問い合わせ名は存在せず、マッチするワイルドカードが存在するが、問い合わせタイプが存在しない場合、「存在しない」のは2つだから、2つのNSEC RRが必要となる。すなわち、問い合わせ名をカバーするNSEC RRと、ワイルドカードに一致する(タイプが存在しないことを示す)NSEC RRである。

ワイルドカードのNSEC RRは、権威セクションにコピーされると、名前がワイルドカードから、問い合わせ名に変更される。それに対するRRSIGをそのまま検証すると、書き換えのせいで、失敗する。

RRSIGがワイルドカードに対して作られたことを示すために、RRSIGにはラベルの数を格納するフィールドが存在する。"bar.example.jp" のラベル数は3である。一方で、ワイルドカードはラベルとして数えないので、"*.example.jp"のラベル数は2である。RRSIGの名前のラベルの数と、ラベル数のフィールドにある値が一致しなければ、そのRRSIGはワイルドカードから生成されたと判断でき、署名の検証の際はラベルをワイルドカードに戻せる。

証明書圧縮

TLS レコード・サイズ制限拡張では、証明書圧縮について書くことはないと言ったが、書くべきことが出てきたので記録しておく。この前、Haskell tls ライブラリと一緒に配布しているテストプログラム tls-client が graph.facebook.com と通信できないという報告を受けた。

デバッグ・メッセージを見ると、圧縮された証明書の直後で、CertificateVerify の検証に失敗している。CertificateVerify とは、この直前にサーバが送ってくる証明書が本当にそのサーバのものだという証拠である。簡単に言えば、サーバが「あるデータ」に施した署名だ。証明書に入っている公開鍵で検証すれば、本当にそのサーバが対応する秘密鍵を持っているかが分かる。

「あるデータ」とは、ClientHelloから証明書までのクライアントとサーバが交換したハンドシェイク・メッセージに対する暗号学的ハッシュの値である。TLS 1.3では、これをトランスクリプト・ハッシュと呼ぶ。

トランスクリプト・ハッシュは、基本的には連結したハンドシェイク・メッセージに対する暗号学的ハッシュの値だが、HelloRetryRequestに対してはハッシュのハッシュを取らなければならず、扱いが煩わしい。そのため Haskell tls ライブラリにはトランスクリプト・ハッシュをトレースする機能を実装した。tls-clientでは--trace-keyオプションを指定すると、トランスクリプト・ハッシュの経過が可視化される。ただし、トレース機能はサーバ側と対で使わないと、あまり有益でないかもしれない。

試しに証明書圧縮の機能を無効にしてみると、graph.facebook.comとちゃんと通信できた。次に、Wiresharkでパケットをダンプしてみたが、原因はよく分からなかった。しかし、サーバがCertificateVerifyに使うトランスクリプト・ハッシュの値とクライアント側のそれとが異なるのは確実だ。

伸長した証明書を眺めてみたが、どこにも問題がない。何が原因なんだろう? ここで、伸長した証明書をクライアント側でもう一度圧縮してみたところ、サーバ側の圧縮率と異なることを発見した。

分かった!分かった!

Haskell tls ライブラリのダサいと思っていたところを見事に突いているバグだ。Haskell tls ライブラリの送信側は、符号化したワイヤーフォーマットに対してトランスクリプト・ハッシュを計算し、ネットワークに送信する。

一方で受信側は、相手が送って来たワイヤーフォーマットに対してトランスクリプト・ハッシュを計算するのではなく、次のような処理をする。

  1. ワイヤーフォーマットを復号して、Haskell のデータ構造に直す
  2. Haskell のデータ構造を再びワイヤーフォーマットに符号化してトランスクリプト・ハッシュを計算する

圧縮率が異なれば、ワイヤーフォーマットも異なり、従って間違ったトランスクリプト・ハッシュの値が算出される。

このような冗長な符号化が採用されているのは、コードが簡潔になるからだ。ここは気に入らなかったので、以前修正しようと試みたが、大幅な改良が必要になることが分かり諦めた。しかし、今回は直さなければいけないバグがそこにあるので、やる気が出る。

というわけで、受信側に新しいトランスクリプト・ハッシュの仕組みを実装しマージした。ユニット・テストも、tlsfuzzerによる回帰テストも、graph.facebook.comとの相互接続性試験も通ったので、たぶん安定している。この実装には、トレース機能が大活躍したので、作っておいてよかった。

HaskellによるQPACKの実装

いやいや、難産だったよ。

2020年から2021年にかけて、HaskellでHTTP/3ライブラリを作成する過程で、QPACKを実装した。HPACKやQPACKでは、圧縮を担う符号器(encoder)よりも、伸長を担う復号器(decoder)の方が、圧倒的に簡単である。このため、Haskellの復号器は、静的表に加えて動的表も使うように実装できたが、符号器は難し過ぎて静的表しか活用しない状態でライブラリをリリースした。

2021年に執筆した「QUICをゆっくり解説(16):ヘッダ圧縮」の「おわりに」では、

私の現時点の実装では、圧縮側は動的表を全く利用していません。この記事を書いたことをきっかけに、実装に挑戦してみようかと思います。

と表明してた。

あれから4年。ようやく時間が取れたので、符号器を動的表に対応させる宿題に取り組んだ。

このブログは、QPACKを実装した経験の備忘録である。HPACKは知っているけど、QPACKはよく分からない人の役に立つかもしれない。

用語は、今どきの IETF 用語に合わせる。

  • フィールド名 - 世間で言うヘッダ名
  • フィールド値 - 世間で言うヘッダの値
  • フィールド:フィールド名とフィールド値の組
  • セクション - フィールドの集合。いわゆるヘッダ。

仕様

QPACKの目的は、HPACKの Head-of-Line ブロッキングを「緩和」することである。HPACKでは、セクションが圧縮された順番で、伸長される必要があった。パケットの欠損などにより、途中の伸長が止まれば、たとえ以降のセクションが届いていても、伸長の工程は止まる。

QPACKでは、伸長側(復号器)をできるかぎり並列化できるように設計されている。鍵となるアイディアは、「動的表の更新命令」(encoder instruction)と「フィールド表現」(field representation)を分離することである。

HPACKでは、これらの区別がなかった。そのため、動的表を変更するセクションに次のセクションが依存し、後続のセクションもまた依存しと、依存の連鎖が起きていた。

QPACKでは、動的表の更新命令を一方向ストリームで送る。フィールド表現は、HTTPのリクエスト&リスポンスをやりとりするための、双方向ストリームで送る。このHTTPのストリームは、更新命令を送るストリームにのみ依存する。

動的表の更新命令

動的表に登録されるエントリは、フィールドである。動的表の更新命令(encoder instruction)は以下の通り:

  • 動的表の大きさの設定
  • 「文字列のフィールド名」(literal)を使ったエントリの挿入
  • 「フィールド名の参照」(index)を使ったエントリの挿入
  • エントリの複製 (duplicate)

HPACKでは、静的表と動的表のインデックスが同じ空間として扱われていた。静的表のエントリ数は61なので、動的表のインデックスは62から始まる。動的表は62以降をFIFOとして使う。つまり、新しく挿入したエントリのインデックスは62であり、その挿入によって元々のエントリのインデックスは1増加する。動的表の大きさを超えた古いエントリは、動的表から削除される。明示的な削除命令はない。

QPACKでは、静的表と動的表のインデックスは、別の空間として扱われる。動的表のインデックスは、単調に増加する。単純に大きなインデックスを符号化すると、バイト数が大きくなるので、動的表の更新命令では、「挿入点」(insertion point)からの相対値で表現される。挿入によって動的表の大きさの制限を超えると、必要な分、古いエントリが削除される。明示的な削除命令はない。

ここが重要なのだが、QPACKの動的表に挿入するエントリは、これから追い出されるエントリを参照してもよい。もちろん、追い出された後のエントリは参照してはならない。

フィールド表現

フィールド表現は、以下の3つに大別される。

  • インデックスを使ってフィールドを表現する
  • インデックスを使ってフィールド名を表現し、フィールド値には文字列を使う
  • フィールド名にもフィールド値にも文字列を使う

符号器は、これから圧縮するセクションに対して、現在の挿入点を「基準点」(base point)として指定する。フィールド表現で使われるインデックスは、バイト数を抑えるために、基準点からの相対値を利用する。圧縮開始までに挿入されているエントリのインデックスは、基準点よりも小さい。圧縮中に挿入されたエントリのインデックスは、基準点の値以上となる(post base-indexing)。

重要なのは、(「動的表の更新命令」の節で説明した「これから追い出されるエントリ」も含めて)動的表にないエントリは、参照してはならないことである。

並列化

圧縮されたセクションには、圧縮されたフィールドと基準点に加えて「必要挿入数」(required insert count)が付与される。復号器の動的表に、少なくとも必要挿入数分のエントリが挿入済みであれば、そのセクションの伸長は「ブロックされない」。不足していれば、「ブロックされる」。

復号器は、動的表に挿入されたエントリの数を以下のACK(decoder instruction)によって通知できる。

  1. 動的表に新たに何個エントリを挿入したかのACK
  2. 圧縮されたセクションを伸長できたことのACK

1)は直感的に分かりやすい。動的表の更新命令に対して、ACKを返すからである。2)は、復号側で動的表を管理しないコードが発するACKなので、少し分かりにくい。

実装モデルとして、スレッド・プログラミングを考えよう。リクエスト&リスポンスに1スレッドを割り当てるとする。(1HTTPストリーム、1スレッドという意味。)

リクエストは同時に複数発生するかもしれない。実装して分かったのだが、圧縮側には並列性は必要ない。HoLブロッキングは、伸長側の問題なので、圧縮側は直列に実装するのが理にかなっている。

あるスレッドがリクエストのセクションを圧縮する際は、動的表をロックする。そして、動的表の操作命令が発生した場合は、それを専用の一方向ストリームで送る。また、圧縮したセクションを、双方向のHTTPストリームで送信する。

伸長側では、動的表の操作命令を一方向ストリームから読み取り、動的表を操作する専用スレッドが必要である。このスレッドのみが、動的表に書き込む。書き込めたら、「この専用スレッドが1)のACKを返す」。

リクエストが送られてくるHTTPストリームを読み込むスレッドは、動的表を読む。読むだけなので、並列化できる(ロックは必要ない)。動的表に必要なだけエントリが挿入されていれば、このスレッドはブロックされない。そうでなければ、ブロックされる。セクションの伸長が終わったら、「このHTTP用のスレッドが2)のACKを返す」。

圧縮側にも、ACKを読み込んで処理するための専用スレッドが必要である。2)を処理するためには、あるセクションに対する「ストリーム番号」と「必要挿入数」を記録しておく必要がある。2)のACKが返れば、その必要挿入数分、挿入されたと判断できる。

動的表を参照しない場合、符号器は必要挿入数に0を指定する。復号器は、必要挿入数が0の場合、2)のACKは返さない。

ブロックされてもよいストリーム数

動的表の大きさに加えて、もう一つのパラメータとして、「ブロックされてもよいストリーム数」がある。この値が許す限り、送信側は、「ACKが返っていない動的表のエントリを参照したフィールド表現」を含むセクションを送信してもよい。

伸長側は、2)のACKを返すだけで十分であると考えがちだが、実際は1)のACKも返す必要がある。たとえば、現在のブロックされてもよいストリーム数が0だとしよう。

  • 圧縮側は、将来のために動的表の挿入命令を送る
  • ブロックされてもよいストリーム数が0なので、新たに挿入したエントリは参照できない
  • 動的表をまったく参照しないで圧縮した場合、必要挿入数には0が指定される
  • 伸長側は、そのセクションを伸長する際、必要挿入数が0なので、2)のACKは返さない

これだけだと、将来使うためのエントリには、ACK は返ってこないので、いつまでたっても利用できない事態に陥る。そこで、伸長側は、少なくとも必要挿入数が0の場合、1)のACKを返す必要がある。

そろそろ、嫌になってきたでしょ。

動的表の大きさ

HPACKもQPACKも最初の大きさは0で、初期値を交渉することで、大きさを決定する。HPACKでは、最初のセクションを送信する前に、大きさが決定されることが保証されている。QPACKでは、初期値の交渉を待たずに、セクションを送ることができ、その場合の動的表の大きさは、もちろん0である。この短い期間内では、動的表は使えないので、静的表だけ活用してセクションの圧縮を試みる。

後述のように、この性質をうまく利用したエントリ管理の方法(ニーモニック技法)がある。

エントリの削除

HPACKでは、動的表の末尾から自由にエントリを削除できた。

QPACKでは、動的表の各エントリに対して、どのセクションから参照されているかのリファレンス数を管理しないといけない。参照する際にリファレンス数を増やし、2)のACKが返って来れば、対応するエントリのリファレンス数を減らす。

動的表の末尾のエントリは、リファレンス数が0の場合にのみ削除できる。つまり、エントリを挿入する際は、末尾からリファレンス数が0のエントリが連続しているかを調べ、「それらの合計数」と「未使用の大きさ(使いきれないギャップ)」の合計が、新たに挿入するエントリの大きさ以上の場合に限り、そのエントリを挿入できる。

末尾にリファレンス数が0のエントリが連続するようにする技法として、RFC 9204では「排除点」(draining point)が紹介されている。見付かったエントリが、排除点よりも小さい場合は、利用しない。そうすれば、新たな参照は発生しないので、いずれリファレンス数が0になるという訳である。

Haskellでの実装

Haskellには軽量スレッドがあるので、上記のスレッド・プログラミングを採用している。

初期実装

符号器を動的表に対応させる初期の実装としては、RFC 9204 の内容に従って排除点を利用していた。動的表から見付かったエントリのインデックスが、排除点よりも小さい場合、それは利用しない。可能であれば、そのエントリを複製して、利用しようとする。

この時点でのコードは、見通しが悪かった。なぜなら組み合わせ爆発が起きていたからである。

  • 検索結果の種類
    • 「フィールド」が見付かった
    • 「フィールド名のみ」が見付かった
    • 見付からなかった
  • 表の種類
    • 静的表
    • 動的表
  • 排除点との関係
    • 排除対象
    • 排除対象外

QIFs

QIFsとは、QPACKの相互接続性検証プロジェクトである。ここには、Facebook と netbsd.org でサンプリングされたセクション群と、各QPACK実装での圧縮結果が置かれている。

Haskellの復号器は、これらの圧縮結果を伸長することで、正しさを検証していた。

圧縮するためのパラメータは以下の通り:

  • 動的表の大きさ:0、256、512、4096
  • ブロックされてもよいストリーム数:0、100
  • ACK: ACKはまったく返されない(no)、すぐにACKが返される(yes)

ACKに関しては、解釈の範囲が広い。Haskellのテストプログラムでは、あるセクションに対して、ある圧縮したセクションと動的表の操作命令両方を送信し終えた直後、1)と2)のACKが返ってくるという解釈を採用した。(動的表の操作命令ごとに1)のACKが返るのではなく、セクション単位でまとめて返るという意味。)

長い期間、他の実装と圧縮率の傾向に相違があって、ずいぶんと悩んだ。そうして、ようやく期待される振る舞いを理解した。下2つのパラメータの組み合わせに対して、符号器の期待される振る舞いを記す。

  • (0, no):動的表は育ててもよいが、ACKは返ってこないので、動的表はまったく参照できない
  • (0, yes):育てた動的表は、次のセクションから利用できる。
  • (100, no):100個のセクションまでは、挿入したエントリをすぐに利用できる。101個目以降は、動的表は活用できない。
  • (100, yes):挿入したエントリをすぐに利用できる。

ngtcp2/nghttp3

QIFs のセクションを Haskellの符号器で圧縮した結果は、まず Haskell の復号器で伸長できることを確かめた。

次に、ngtcp2/nghttp3を使って、Haskellで圧縮したセクションを伸長できるか検査した。ngtcp2/nghttp3の実装は、極めて正確であり、安心して信頼できた。また、僕が慣れているC言語で書かれているので、printf debug できるようにコードを変更しやすかったのも助かった。

ニーモニック技法

QIFs に圧縮結果を登録しているLITESPEEDのブログサイトに「Developer’s Corner: QPACK Mnemonic Technique」という記事を発見した。

QPACKに挿入されるエントリは、HPACKよりも追い出しにくいので、挿入するエントリを慎重に選ばないといけない。多くの実装では、フィールド名ごとに挿入するかしないかの情報をアドホックに定義して使っている。

この記事で紹介されている「ニーモニック技法」のアイディアはこうだ。利用されたフィールドの「集合」を管理する。その集合を利用して、2回以上フィールド(あるいはフィールド名)が利用された場合に限り、動的表に挿入する。

最初の出現では動的表には登録しないので、それがよく使われるフィールドであれば、出遅れた分、圧縮率が悪くなるかと思いきや、動的表の大きさの初期値は0なので、ペナルティは発生しないのである。

Haskellでも、ニーモニック技法を採用している。

逆インデックスと排除エントリ

「排除エントリが見付かった場合には複製すべき」という思い込みによって、初期実装では、組み合わせ爆発が起きていた。あるとき、「複製は一旦あきらめて、排除エントリを検索対象から外せば組み合わせの数が低減されるのでは?」というアイディアを思いついた。

動的表にインデックスでアクセスするとフィールドが得られる。逆にフィールドからインデックスを得るためには、何も工夫がなければ、動的表を端から端まで走査しなければならない。

Haskellの符号器では、高速化のために逆インデックスを持っている。この逆インデックスから排除エントリを排除することにした。検索できるエントリは、排除エントリでないことが保証されたため、コードが簡潔になった。

そもそも、ニーモニック技法を使っているので、排除点が不要なのではないかと思って試したが、排除点は圧縮率に貢献していることが分かった。

フィールド名

圧縮率を比較していて、なかなかLITESPEEDの性能に迫れなかったとき、LITESPEEDの圧縮結果を解析すると、LITESPEEDでは動的表の(フィールドではなく)フィールド名をうまく活用していることが分かった。

動的表のフィールド名は、QPACKの魔境である。

動的表をフィールドのみで利用するのであれば、逆インデックスは「フィールド→インデックス」というデータ構造で済む。フィールド名(のみ)も利用するのであれば、「フィールド名→(フィールド値→インデックス)」というデータ構造が必要となる。

あるフィールド名に対して、「フィールド値→インデックス」は複数登録されうるから、どのエントリを利用するかが問題となる。最近のエントリを使うと「必要挿入数が大きくなる」(ブロックされる確率が上がる)し、古いエントリを使うと「リファレンス数が増えて、そのエントリを削除しにくくなる」というジレンマがある。

さらに、古いエントリが排除エントリであるかもしれないという問題もあったが、この問題は上記のアイディアで考えなくてもよくなった。排除エントリでない、もっとも古いエントリを発見するために、「フィールド値→インデックス」のデータ構造としては、PSQ(Priority Search Queue)を利用することにした。

  • key はフィールド値
  • value はインデックス
  • priority もインデックス

とすると、

  • key による検索は O(log n)
  • key による削除は O(log n)
  • 最小の priority のエントリを発見するには O(1)

である。

これに加えて、ニーモニック技法の集合にも、フィールド値を空文字列としたフィールドを登録しなければならない。

動的表のフィールド名を参照しながら、動的表に新しいエントリを追加する場合、参照したエントリが動的表から削除される可能性がある。フィールド表現では、この削除されたエントリを参照してはならない。

末尾複製

複製に関して、末尾複製(tail duplicate)というアイディアを思いついた。動的表の操作命令では、これから削除されるエントリを参照してもよい。末尾を複製すれば、先頭に追加されたエントリと末尾のエントリのサイズは同じなので、動的表の大きさを気にせずに削除できる。(ただしリファレンス数が0の場合に限る。)

あとは、いつ末尾複製するかである。いろいろ試したが、動的表がいっぱいでフィールドを挿入できない場合、つまり「フィールド名にもフィールド値にも文字列を使う」フィールド表現を発行した場合に、末尾のエントリのリファレンス数が0であり、これまで一定数(現在は10)使われていたなら、末尾複製するのが一番圧縮率が高かった。

圧縮率

参考までに、現時点での圧縮率の結果を示す。

qifs/encoded/qpack-05/haskell-quic/fb-resp.out.4096.0.0   62.0
    qifs/encoded/qpack-05/ls-qpack/fb-resp.out.4096.0.0   62.0
     qifs/encoded/qpack-05/nghttp3/fb-resp.out.4096.0.0   82.9

qifs/encoded/qpack-05/haskell-quic/fb-resp.out.4096.0.1   18.9
    qifs/encoded/qpack-05/ls-qpack/fb-resp.out.4096.0.1   17.3
     qifs/encoded/qpack-05/nghttp3/fb-resp.out.4096.0.1   37.6

qifs/encoded/qpack-05/haskell-quic/fb-resp.out.4096.100.0 50.4
    qifs/encoded/qpack-05/ls-qpack/fb-resp.out.4096.100.0 50.8
     qifs/encoded/qpack-05/nghttp3/fb-resp.out.4096.100.0 50.6

qifs/encoded/qpack-05/haskell-quic/fb-resp.out.4096.100.1 19.7
    qifs/encoded/qpack-05/ls-qpack/fb-resp.out.4096.100.1 15.2
     qifs/encoded/qpack-05/nghttp3/fb-resp.out.4096.100.1 19.4

これは、あくまでFacebookのサイトのサンプリングに対する結果である。入力データが変われば、結果も変わる。

LITESPEEDの圧縮率に肩を並べるには、複製のアルゴリズムを工夫しなければならないようだが、まだ何もアイディアを思いつかない。

おまけ

HPACKを実装したときとは違って、QPACKの実装過程では、特に目新しいことは発見できなかった。貢献できたことは以下の通り:

謝辞

安定したQPACKの実装を提供しており、またいくつかの質問に答えてくださった Tsujikawa さんに心から感謝します。QPACKに関する素敵なブログを公開してくださった Dmitri Tikhonov さんにお礼を申し上げます。

Encrypted Client Hello の実装

ECHをHaskell tlsライブラリに実装した話。先に「Encrypted Client Hello の仕様」を参照のこと。Haskellで実装した経験談なので、Haskellの知識を前提に書く。

ライブラリの構成

バックエンド・サーバの設定情報である ECHConfigList は、DNSを通じて提供され、TLSクライアントとTLSサーバで利用される。ECHConfigList の型や、その符号器/復号器をどのライブラリで実装するか決める必要がある。

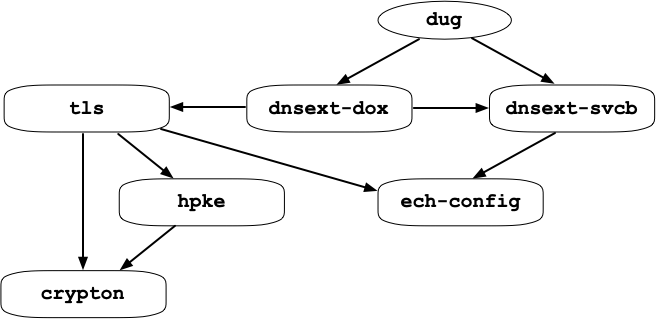
tls ライブラリをECHに対応させると、ECHConfigList を利用するのは当然である。僕の希望としては、IIJが開発している DNS検索コマンドdug で HTTPS RR を検索したときに、ech パラメータが16進数表記されるのではなく、ECHConfigList を利用してユーザに分かりやすく表示されるようにしたい。

dug は、HTTPS RR を提供する dnsext-svcb ライブラリに依存している。ECHConfigList を tls から提供すると dnsext-svcb が tls に依存するし、逆もまたしかりである。両者は本来独立であるので、この依存関係が発生するのは嬉しくない。そこで、依存するライブラリの数が少ない ech-config というライブラリを新たに作り、そこに格納することにした。

ECHConfigList には HPKE のパラメータに関する情報が含まれている。ech-config が、新たに作成する hpke ライブラリに依存すると、単なる型情報を提供する ech-config が、暗号ライブラリ crypton に依存してしまう。これは避けたい。

という訳で、ECHConfigList を適切な型で表現するのは諦めた。たとえば、hpkeライブラリから提供される AEAD_ID を使いたくなるが、それは我慢して Word16 を使うといった具合だ。

最終的なライブラリの依存関係は、以下の図の通り。

ライブラリの依存関係

HPKEの実装

HPKE用のモジュールは、crypton に収めてもおかしくないが、hpkeという別のライブラリにすることにした。hpkeの作成にあたっては、以下のようにcryptonを拡張する必要があった。

  • ChaCha20Poly1305 が AEAD として利用するには中途半端な状態だったので、これを直した。
  • ECDHEの秘密鍵から公開鍵を作る関数は内部で実装されているものの、公開されていなかったので、型クラス EllipticCurve のメソッドとして提供するようにした。

大局的に言うと hpke ライブラリは、HPKEのパラメータと crypton から提供される関数をつなげる役割を果たす。最初はよい構成が発見できず紆余曲折したが、同僚の日比野さんと議論した結果、最終的には以下のように拡張可能な構成となった。

  • HPKE パラメータは、(拡張不可能な直和型ではなく) 拡張可能なように PatternSynonyms を使う
  • HPKE パラメータをキー、呼び出す関数を値とした、連想配列を渡せる内部関数を作り、Internal モジュールから提供して拡張可能とする。
  • デフォルトのAPIでは、この連想配列は渡さなくてよく、簡便に利用できる。
  • crypton の関数は、型クラスで提供されているものが多い。つまり関数名は同一だが、型が異なるので、そのままではリストに格納できない。そこで、存在型を使って同一の型にすることで、連想リストに収める。

RFC 9180の付録にはテストベクターが載っているが、定義されているAPIでは、これらを直接活用することはできない。なぜなら、APIでは、送信側の秘密鍵は内部で動的に生成されるので、秘密鍵を外から指定するのは無理である。そこで、秘密鍵を指定できる内部関数を作って、内部関数をテストの対象とすると共に、API では動的に生成した秘密鍵を内部関数に指定するようにした。

Haskellの型システムは、RFC 9180の仕様にマイナーなバグがあることを教えてくれた。一般的に、鍵を派生させる手続では、共有した鍵を extract して expand する。Export は export_secret を expand するように定義してあるのだが、export_secret はすでに expand した値である。(型の弱いプログラミング言語で考えていると、何でもかんでも文字列で表現するので、よくこういう間違いを犯す。)

ECH Config の実装

下位の符号/復号ライブラリとして、最初は tls で利用されている cereal を利用したが、dnsext-svcb から ech-config を利用してみると、dnsext-svcb が依存している network-byte-order の方がよいことが分かり、そちらに移行した。

ech-config には、設定情報や秘密鍵を生成するためのコマンド ech-gen を収めた。設定情報や秘密鍵をサーバに渡す書式は標準化されていないので、ECH の各実装は独自の書式を採用している。ech-gen は僕が調べた限りの書式を生成する。

また Haskell tls のクライアント・コマンドで、オープンサーバと通信するには、対象サーバの HTTPS RR を引き、echパラメータを抽出するコマンドが必要である。dug に機能追加するという案も検討したが、大掛かりなプログラムなので改造するのは諦め、ech-lookup というコマンドを作成した。ech-lookup は dnsext-svcb に依存するが、dnsext-svcb は ech-config に依存している。このため、ech-lookup は、ech-config 内でビルドすることは諦め、単にリポジトリにソースを追加している状態になっている。

ECH サーバの実装

TLSに対する相互接続性の検証で、僕が一番使っているのは picotls である。これは kazuho さんが作ったライブラリで、クライアントにもサーバにもなれるコマンド cli も提供されている。ビルドが簡単であることに加えて、kazuho さん作だけに信頼性が高い。kazuho さんは ECH 仕様の著者の一人であり、当然のように picotls は ECH を実装している。

調べてみると、ECH に対して cli クライアントを利用する方法が明快だったので、Haskell tls ではサーバ側から作り始めることにした。サーバは ECH 拡張を復号する側である。

「Encrypted Client Hello の仕様」では、便宜上「クライアントに面したサーバ」と「バックエンド・サーバ」を分けて説明したが、これらは同一のサーバとして実装してもよい。Haskell tls の利用方法では、今のところ同一サーバ方式が適していると思われる。理屈の上では、同一サーバ方式では、ECH拡張を復号できたら、取り出せた内部 ClientHello を使い、復号に失敗したら外側の ClientHello を使えばよい。

復号するには、ECDHEの秘密鍵に加えて、「追加データ」として外側のClientHelloを加工する必要がある。面倒であるが時間をかけて実装すると、一番簡単なハンドシェイク・モードである full handshake で picotls と、内側の ClientHello を使って通信できるようになった。

次のモードは HRR(Hello Retry Request) であるが、この実装は困難を極めた。Haskell サーバが HRR を返すと、picotls は最初と同じ ECH 拡張を返してきた。正しいケースでは、暗号化し直した別の ECH 拡張を送ってこなければならない。picotls の ECH は、HRR に未対応なのかもと思い、boringssl を試したがまったく同じ挙動を示した。

ここで行き詰まってしまったが、IETF の TLS メーリングリストに ECH の相互接続性検証レポートが投稿されているのを発見し、著者の Stephen さんにメールを出してみた。彼が進めている DEfO プロジェクトで作成された OpenSSL フォークは HRR に完全対応していると言う。そこで、そのフォークを使ってみたら、2回目の ECH は再び暗号化しているものの、ハンドシェイクで同一の鍵を共有できなかった。

最後の希望である NSS を試すと、2回目の ECH は再び暗号化していて、しかも alert を送ってきた。この alert を生成しているソースの場所を特定したことで、謎が解けた。HRRでは、サーバがECHの受理情報を2回クライアントへ返す。両者が異なる、つまり一方が受理で、他方が拒否の場合、この alert が生成されていた。

分かった、分かった。ようやく分かった。すべての事象をうまく説明できる仮説は、HRRに埋め込む一回目の受理データの計算が間違っていることだ。仕様をよく読み返すと、HRRでECHが拒否された場合、2回目のECH拡張は、1回目と同じものを使うと定義されていた。picotlsや boringssl の挙動の解釈に頭を抱えていたが、正しい振る舞いをしていたのだ。

受理データを正しく生成できなかった理由は、一連のハンドシェイク・メッセージのハッシュ値 (Transcript Hash) の計算が間違っていたからだった。これが契機となり、以前から作りたかったが手をつけてなかった、Transcript Hash のモニター機能を作成した。このおかげで、Transcript Hash に関する大胆なリファクタリングが可能となり、コードの見通しが劇的によくなった。

ECH クライアントの実装

次はクライアントである。もちろん最初は full handshake モードを実装する。当初の印象には反して、サーバよりもクライアントの方がロジックが難しかった。というのは、サーバでは内部と外部のどちらの ClientHello を使うかは、自分で決定できるので、採用しなかった方を忘れることができる。一方で、クライアントは、サーバが受理するか拒否するかは分からないので、内側のClientHello を保持しておく必要がある。

Haskell tls クライアントと picotls サーバは、早い段階で full handshake をできるようになった。

boringssl に関しては、公開サーバの存在も教えてもらったので、そちらを試したがうまくいかなかった。しかし、ローカルでビルドしたサーバとは、通信できた。これは一体どういうことだろう? 公開サーバに使われているコードは、リポジトリから入手できるものとは違うのだろうか?

公開サーバの設定情報を ech-config で復号し表示してみると、違和感があった。たとえば、Cloudflare で公開されている設定情報は、設定が1つしか入っていないのだが、boringsslの公開サーバの設定情報には、設定が複数個含まれていた。AES-128-GCM よりも、ChaCha20Poly1305が優先されているのも「そう言う趣味なのかな」という感じであったが、ech-config が逆順に返していることに気づいた。このバグを直したところ、公開サーバとも通信できるようになった。

すなわち、ECHの暗号化にAES-128-GCMを利用すると通信できるが、ChaCha20Poly1305だと失敗するのである。hpke では ChaCha20Poly1305 に対しテストベクターでテストしているので、間違いはないように思える。また、TLS自体の暗号スイートに ChaCha20Poly1305 が選ばれても、問題なく通信できる。今のところ、boringssl には、ECH 拡張をChaCha20Poly1305 で復号するコードにバグがあるのではないかと疑っている。

DEfO OpenSSLサーバは、設定情報と秘密鍵を PEM 形式で指定する必要があるところに苦労した。NSSサーバは、書式が複雑過ぎるので、ech-gen で生成するのは諦めた。別のモードでは、NSSサーバは、これらを自動生成し、設定情報を表示する。相互接続性の検証には、そのモードを利用した。

Cloudflareは、すでに ECH をサービスインしている。適当なドメイン名のリストに対して、HTTPS RR の ech パラメータを検索させると、2.4% が対応済みであり、クライアントに面したサーバは、すべてcloudflare-ech.com であった。これらのドメインに対して、Haskell tls クライアントは ECH でコネクションを張ることができた。

開発者によく知られた Cloudflare の実験サーバは、crypto.cloudflare.com である。しかし、このドメインは HTTPS RR を公開しておらず、サイトにも ECH の設定情報は書かれていない。頭を抱えていたが、試しに上記で得た設定情報を使ってみると、うまく通信できた。なお、cloudflare-ech.com に対して HTTPS RR を検索すると、答えが返ってくる。なんだかなぁ。

次は HRR である。これまでの大胆なリファクタリングのおかげで、クライアントを HRR に対応させるのは、そんなに難しくなかった。

おわりに

相互接続性の検証に利用したクライアント・サーバの使い方は、ここにまとめてある。

メールでいろいろ教えてくれた Stephen さんに感謝します。